この記事の要点: 製造業の現場では、不良発生時の原因究明において、機械の設定、仕入先ロット、物流履歴など、複数システムにまたがるデータ確認が求められます。しかし、多くの工場ではシステムが部門ごとに分断されており、迅速な追跡が困難です。米Databricksは、既存システムを大規模に移行することなく、データを統合・連携してバリューチェーン全体を横断したデータ分析とAI活用を実現するアプローチを提唱しています。
ニュースのポイント
- システム移行不要で、既存のデータソースをそのまま連携・クエリ可能
- 製品シリアルやロット番号を共通キーとし、バリューチェーンの追跡性を向上
- 自然言語によるデータ問い合わせにより、専門家以外でも現場データを利用可能
背景
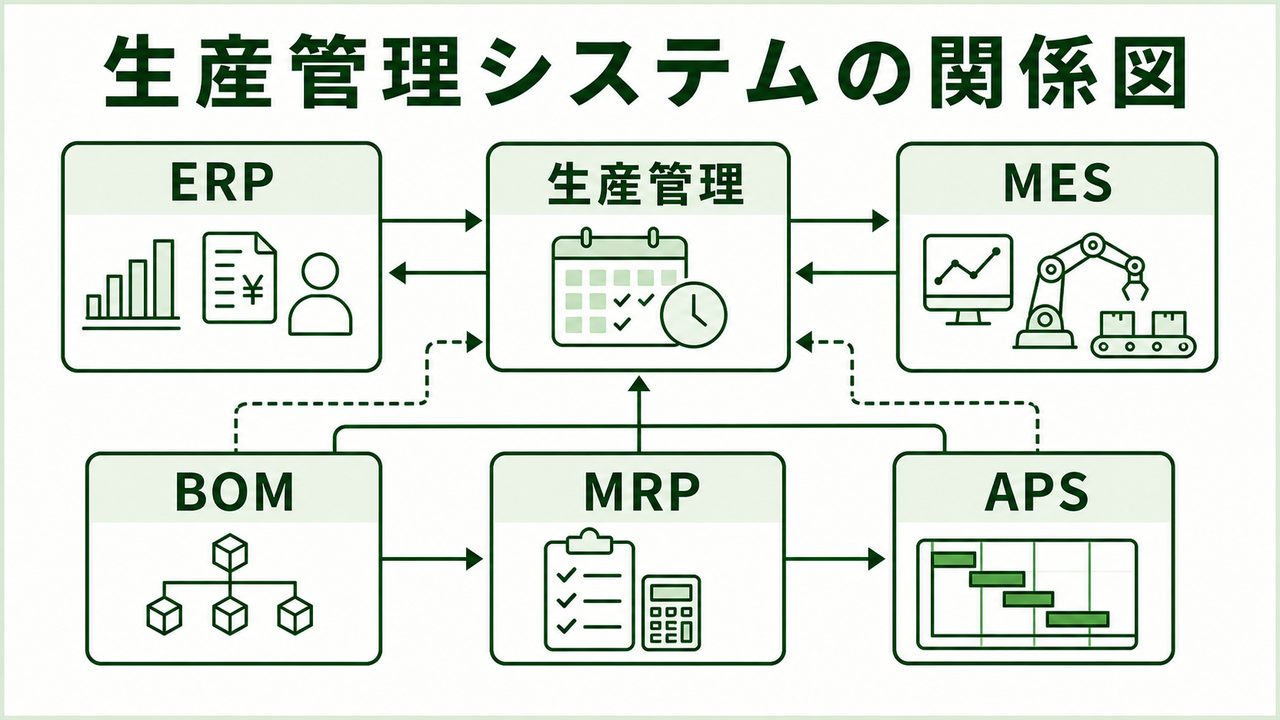
製造業におけるデータは、R&D、調達、生産、品質、物流、サービスなど、バリューチェーンの各段階で個別のシステム(PLM、ERP、MES、QMSなど)に記録されています。これらは相互に連携するよう設計されていないため、不良発生時の原因究明や、特定サプライヤーの供給リスクが及ぼす影響範囲の特定には、手作業でのデータ抽出や照合に多大な時間と手間がかかっていました。
何が起きたのか
Databricksのプラットフォームは、データを一箇所にコピーするだけでなく、元のシステムに置いたままクエリを実行できる「レイクハウス・フェデレーション」などの機能を備えています。これにより、大規模なシステム移行を伴わずに、ERPの購買データやMESの製造実績、QMSの品質履歴などを横断的に紐付けることが可能です。さらに、一元管理されたデータ基盤上でAIエージェントを活用することで、専門的なクエリ言語を使わずに、自然言語で「この部品の不良は過去にも発生したか」といった質問を投げかけ、信頼性の高い回答を得ることができます。
製造業・生産管理への見方
生産管理や品質管理の担当者にとって、部門や工場の壁を越えたデータの可視化は長年の課題でした。本技術により、例えば「ある工場で発生したスクラップ急増の原因が、特定ロットの原材料にあるのか、特定の機械設定にあるのか」を即座にクエリで特定できるようになります。また、サプライヤーの納期遅延リスクが、どの製品や工場、受注残に影響するかを迅速に把握できるため、サプライチェーンのレジリエンス向上と品質改善の高速化に直結します。
現場で確認したいポイント
- 自社の生産、品質、調達データが部門ごとにサイロ化していないか
- 不良発生時、原因究明のために複数システムからの手作業でのデータ抽出に時間を取られていないか
- 現場の担当者がデータ分析を行う際、IT部門への依頼や専門知識が必要な状況になっていないか
確認しておきたい点
自然言語によるデータ検索(Talk to Data)を正しく機能させるには、事前にビジネス用語やKPIの定義を統一し、ガバナンスの効いたデータモデル(セマンティックレイヤー)を構築しておく必要があります。
出典情報
| 出典 | Databricks |
|---|---|
| 公開日時 | Mon, 09/28/2026 – 19:47 |
| 元記事 | Databricksで読む |